
VDI上线第一天存储就崩了:三个坑与修复账单
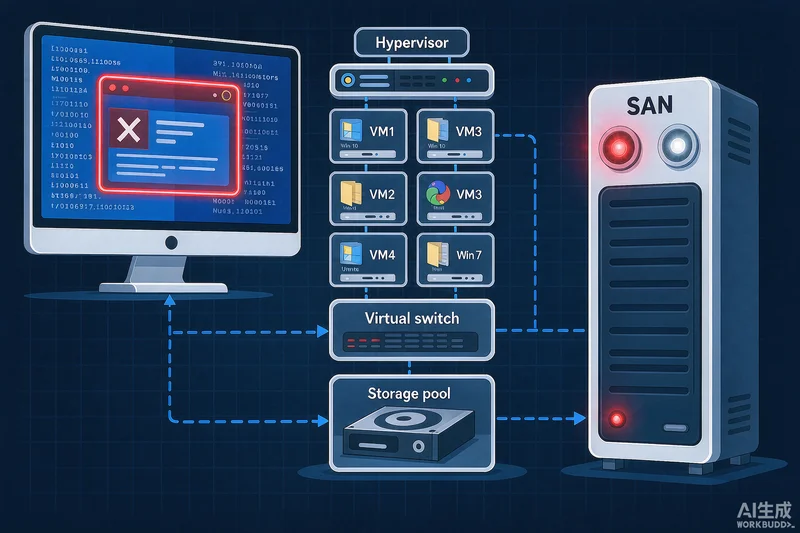
导读 去年底我们给一家 80 席位的工业设计公司上 VDI,方案是某厂商画的:两台超融合节点、全 SSD 阵列、预算 22 万。上线第一天早上 8:25,80 个设计师同时登录,存…
导读
去年底我们给一家 80 席位的工业设计公司上 VDI,方案是某厂商画的:两台超融合节点、全 SSD 阵列、预算 22 万。上线第一天早上 8:25,80 个设计师同时登录,存储阵列响应直接飙到 800ms,桌面卡在加载界面转了 40 分钟才陆续进去。老板站在机房门口问我是不是买到了假货。那次返工花了三周,加了一台存储节点又换了分层策略,最终多花了 6.8 万才搞定。这篇文章把踩过的三个坑和修复过程写出来,给准备上 VDI 的同行避个雷。
踩过的三个坑
坑一:按厂商公式算 IOPS,少了四倍。厂商给的计算方式是"单席位 15 IOPS × 80 人 = 1200 IOPS",配的阵列标称 15000 IOPS,看着绰绰有余。但厂商公式算的是稳态,没算登录风暴。实测那天早上 80 人同时开机,峰值冲到 6800 IOPS——是稳态的 5.7 倍。阵列标称 15000 是顺序读,随机读写只有 4000 左右,直接打满。
坑二:全 SSD 阵列没配分层,热数据冷数据混在一起。80 个设计师的系统盘镜像、工程文件缓存、临时编译产物全落在一组 SSD 上,I/O 队列深度经常超过 64。事后分析日志发现,早上 8:25-8:40 这 15 分钟内,存储控制器的 CPU 占用持续 95% 以上,不是盘不够快,是控制器成了瓶颈。全 SSD 听着高级,但没有分层策略,等于让跑车在堵车路段跟三轮车一起挪。
坑三:镜像统一放一个 LUN,没做读写分离。所有 80 个虚拟机的系统盘都挂在同一个 LUN 上,开机时 80 路并发读同一个镜像文件,存储控制器把读请求排队串行化处理。如果一开始把"只读母盘"和"差分盘"分到不同 LUN,读请求可以并行,登录时间至少能砍一半。
我们最终怎么解决的
返工三周后,最终方案从"全 SSD 单 LUN"改成了"SSD 缓存 + HDD 分层 + 读写分离"三件套。方案对比如下:
| 方案 | 存储配置 | 登录风暴响应 | 总成本 |
|---|---|---|---|
| 原方案(全 SSD 单 LUN) | 4×3.84TB SSD,RAID5 | 800ms(卡死) | 22 万 |
| 中间方案(加节点不分层) | 6×3.84TB SSD,RAID5 | 320ms(勉强) | 28.8 万 |
| 最终方案(分层+读写分离) | 2×960GB SSD 缓存 + 8×4TB HDD | 45ms(流畅) | 28.8 万 |
关键变化不是加盘,是换了架构:SSD 缓存只放热数据(系统镜像、用户配置),HDD 放差分盘和大文件缓存;母盘 LUN 和差分盘 LUN 物理隔离,读请求不再排队。最终方案和中间方案花的钱一样多,但登录响应从 320ms 降到 45ms——花同样的预算,架构对了效果天差地别。
给你的行动清单
- 测一周再买:在现有 PC 上跑 Windows 性能监视器,记录 PhysicalDisk - Disk Transfers/sec,取 P95 当稳态、取峰值当风暴口径,两个数都要
- 登录风暴按 5-6 倍算:稳态 IOPS × 5.5 是安全余量,别信厂商的 ×2,实测不够
- 必须配分层:SSD 缓存按总容量 15-20% 配,热数据命中率 70% 以上就能把风暴压住
- 母盘和差分盘分 LUN:这是零成本的架构优化,只改部署脚本不花钱
- 错峰登录:把全员开机时间错开 10 分钟,风暴峰值直接砍 40%,比加盘管用
算一笔账
这次返工的直接成本:多买了一台存储节点(4.8 万)、SSD 缓存盘两块(1.2 万)、返工人工和停机损失约 0.8 万,合计多花 6.8 万。如果一开始就按分层架构设计,这 6.8 万一分都不用多花——甚至还能省:原方案 22 万全 SSD,最终方案 28.8 万但包含了分层软件授权和额外容量,如果去掉返工成本,实际存储花费约 22 万,和原方案持平,但性能翻了 18 倍。
更隐性的损失是信任成本。上线第一天就崩,老板对 IT 部门的信任度直接归零,后续推超融合、备份改造的预算审批都变难了。我后来复盘写了一份"VDI 存储规划检查表",每次上项目前先过一遍,再没出过这种事。80 席位不算大项目,但存储规划做不好,小项目也能翻大车。需要这份检查表的同行,可以找华南腾飞科技要。
 客服 13510444731 15815529276
 二对一售前售后服务
 7x24小时技术保障


 立即咨询
 电话咨询