

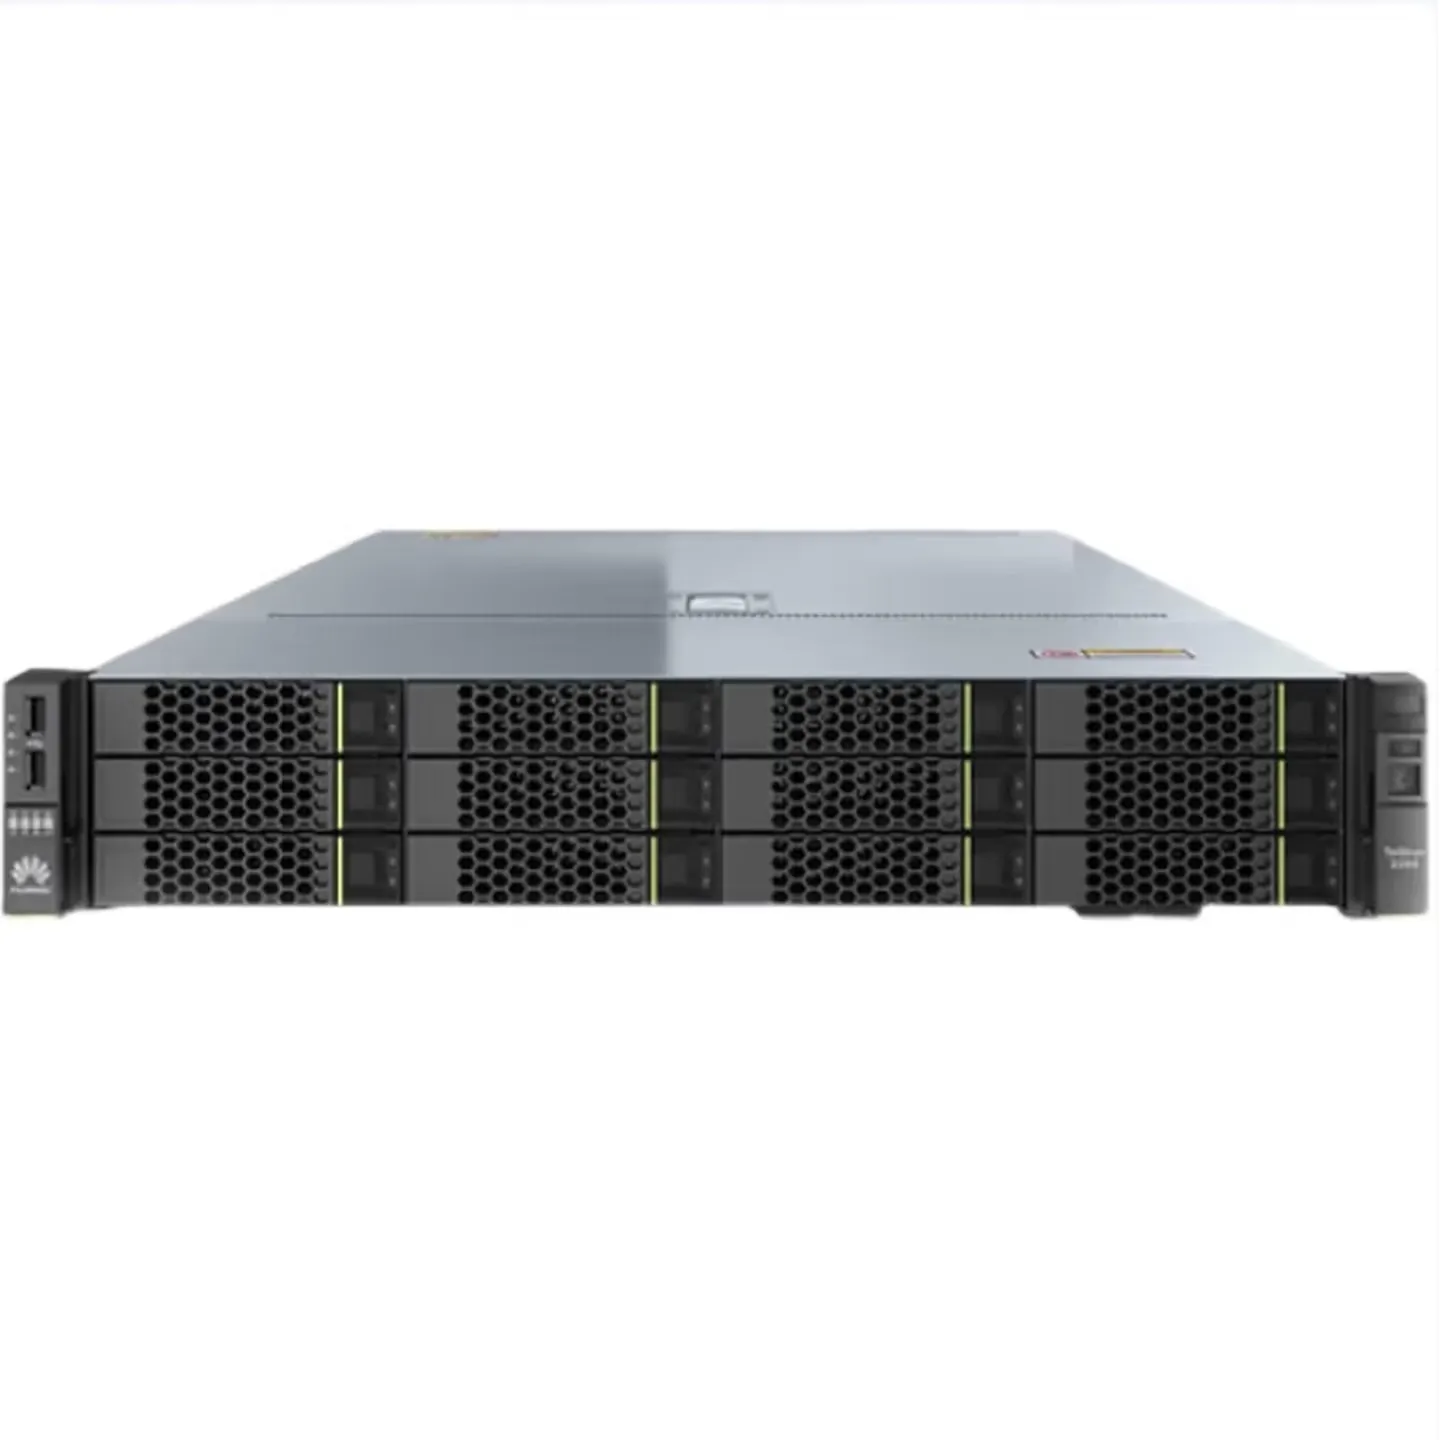
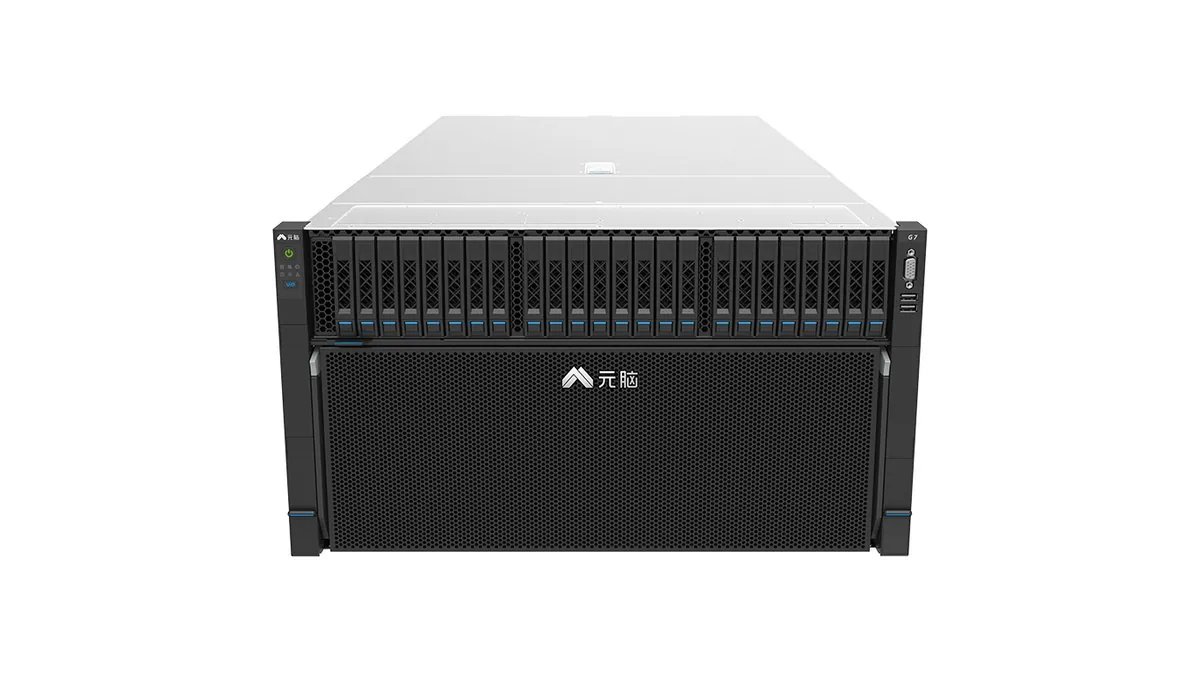
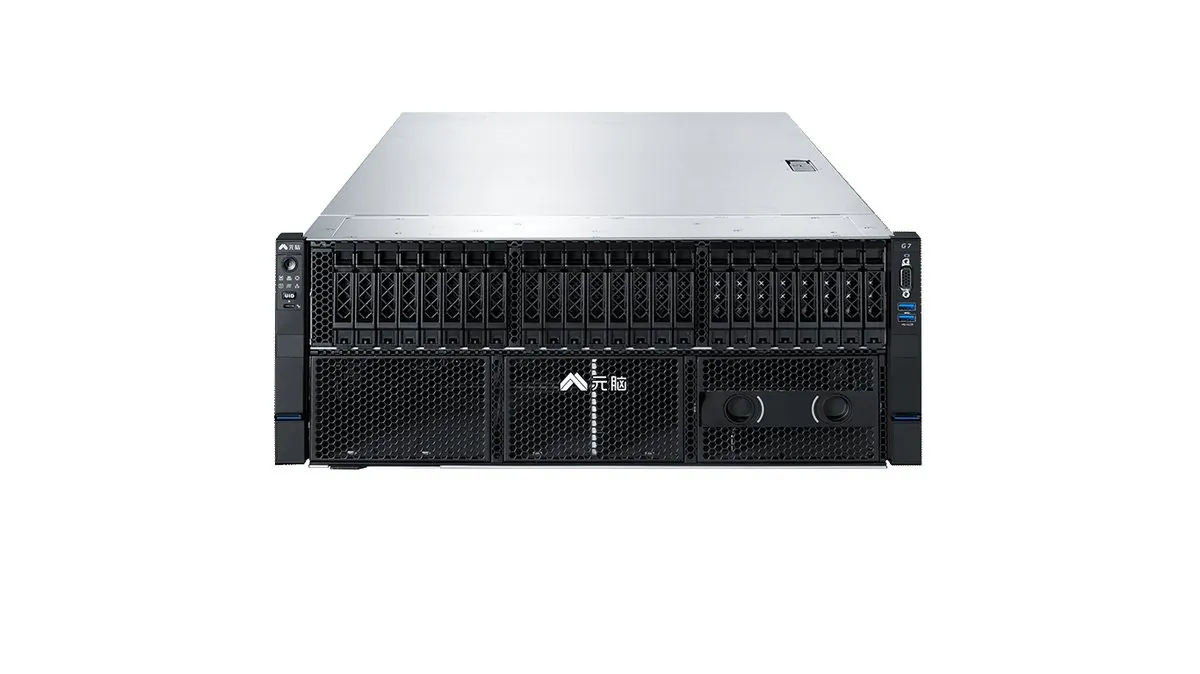
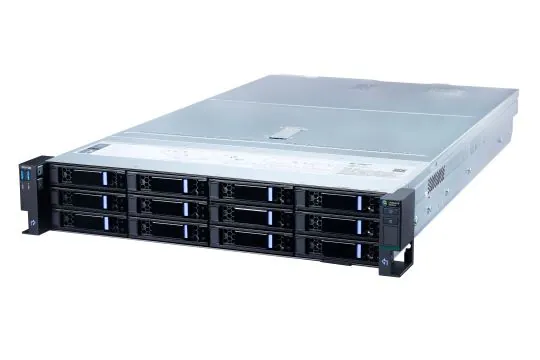
华南腾飞智算GS5500 4U高密8卡GPU算力服务器
产品概述专为企业大模型训练与科学计算打造,支持8张高性能GPU高速全互联,提供极致算力与高能效散热架构。规格参数形态4U机架式GPU8卡全高全长互联NVLink全互联供电冗余4x3…
产品概述
专为企业大模型训练与科学计算打造,支持8张高性能GPU高速全互联,提供极致算力与高能效散热架构。
| 规格 | 参数 |
|---|---|
| 形态 | 4U机架式 |
| GPU | 8卡全高全长 |
| 互联 | NVLink全互联 |
| 供电 | 冗余4x3000W |
典型配置与参考投入
| 部件 | 推荐规格 | 参考区间 |
|---|---|---|
| 处理器 | 双路 96核 2.4GHz+ | 2.0-3.5万/颗 |
| GPU | 8x 高性能加速卡 80GB显存级 | 按算力档位配置 |
| 内存 | 32x DDR5 4800 ECC | 16-30万 |
| 存储 | 2x 3.84TB NVMe + 8x 16TB SATA | 4-8万 |
* 2026年市场参考区间,以实际选配报价为准。
选型对照:GS5500 vs GS2200
| 维度 | GS5500(8卡旗舰) | GS2200(4卡推理) |
|---|---|---|
| 定位 | 大模型训练/科学计算 | 私有化推理/视觉分析 |
| GPU互联 | NVLink 全互联 | PCIe 互联 |
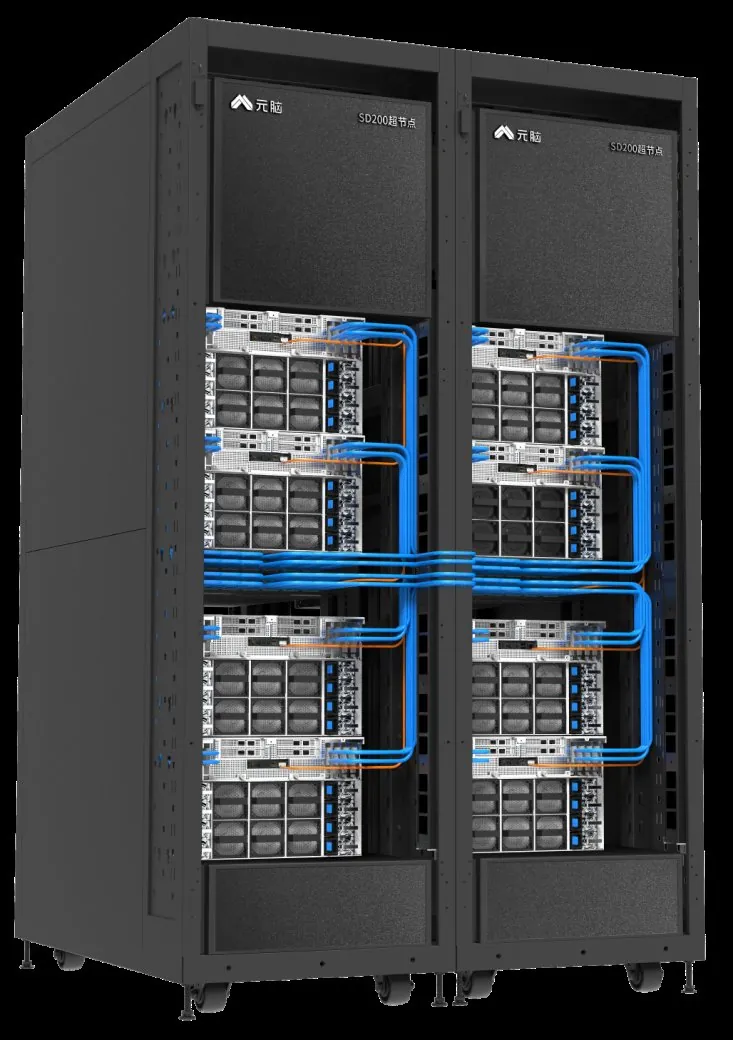
| 单柜密度 | 4U 高密, 配液冷/风液混冷 | 2U 紧凑, 风冷即可 |
典型部署场景
- 大模型LoRA微调: 8卡并行训练7B-14B参数模型, 较4卡方案训练时长缩短约40%
- 科学计算: 分子模拟/CAE仿真 GPU加速, 配合InfiniBand组网组建HPC分区
- AI推理聚合: 配合vLLM/TensorRT-LLM承载高并发推理, 吞吐提升3-5倍
常见问题
Q: 8卡全互联对机房供电要求? A: 建议单柜预留30kW+高密供电, A+B双路冗余; 整机功耗随GPU档位约6-12kW, 建议搭配冷板液冷或风液混冷。
Q: 交付周期? A: 标准配置现货7-10天, 定制含液冷改造约3-4周, 含上门安装与压力测试。
相关方案
华南腾飞企业级 IT 与数据中心交付服务标准
- 14 年本地深耕经验:华南腾飞科技专注深圳及大湾区企业级 IT 基础设施与数据中心建设 14 年,累计服务数千家企业客户。
- 原厂认证伙伴:深信服铂金授权代理商、华为/联想授权合作伙伴,所供产品货源 100% 正品行货并支持原厂联保。
- 交付保障:设备到货后由资深工程师提供标准化安装、配置调优、压力测试与培训移交,交付周期严格承诺。
- 大湾区内 2 小时应急响应:技术工程师常驻深圳,辐射大湾区,支持 2 小时上门应急处理与年度巡检服务。
 客服 13510444731 15815529276
 二对一售前售后服务
 7x24小时技术保障


 立即咨询
 电话咨询