CRUSH怎么分配数据?底层原理拆解
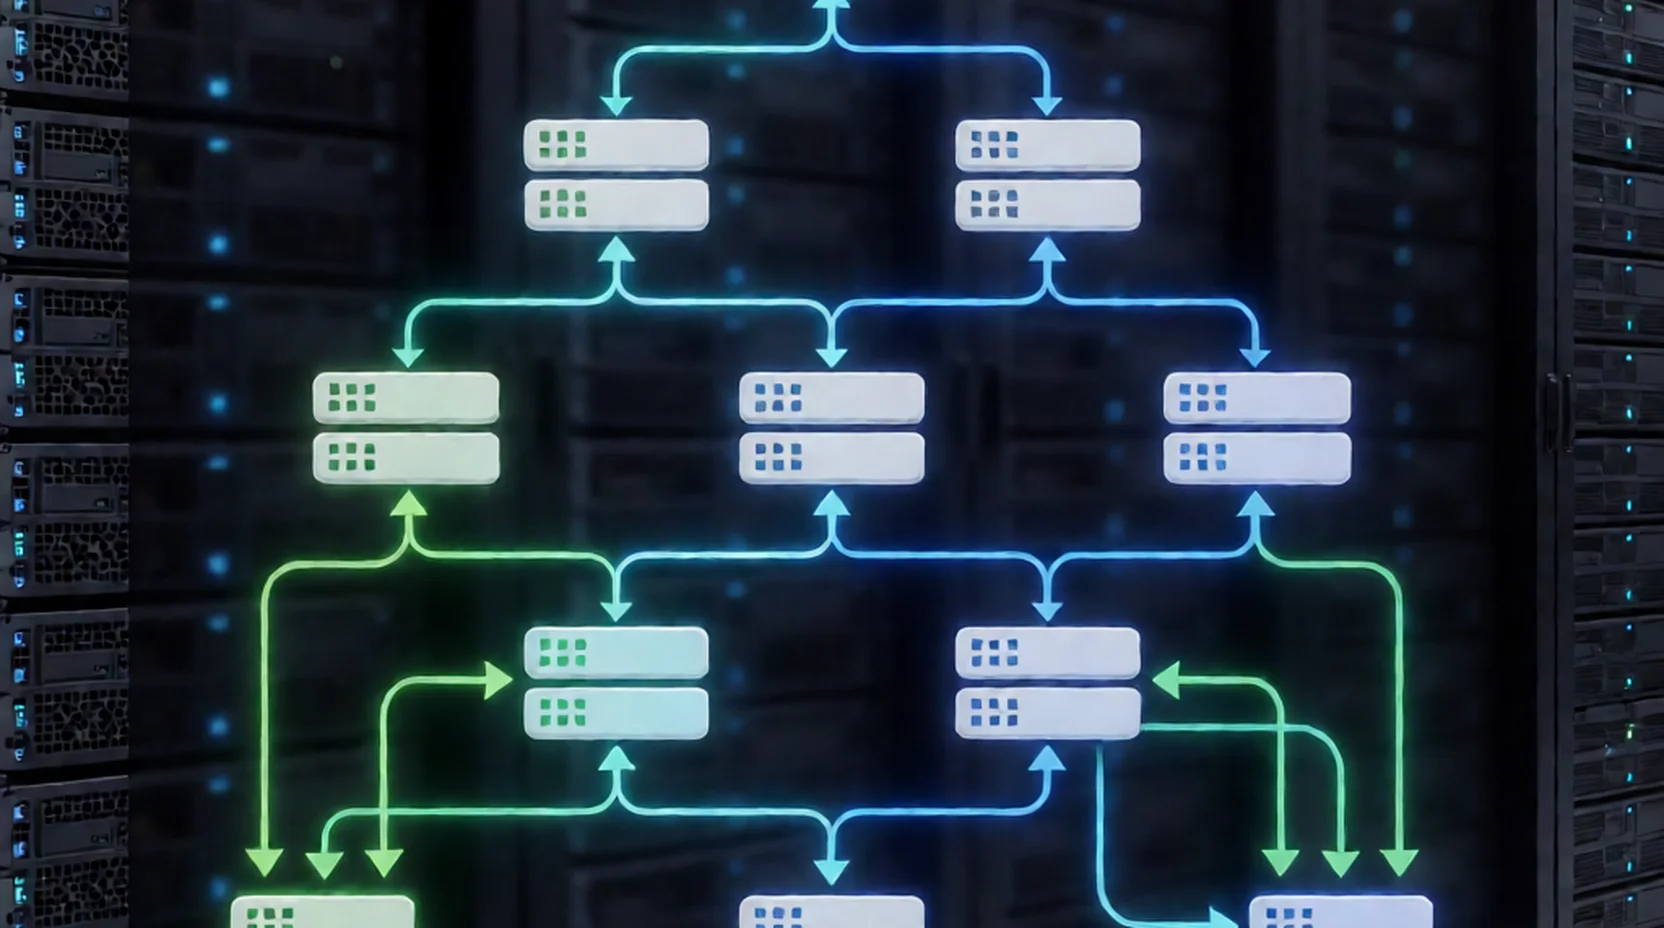
从PG映射到OSD选择,拆解CRUSH算法在分布式存储中的数据分配流程、故障域隔离机制及实际工程注意事项。
CRUSH算法怎么分配数据?分布式存储底层原理拆解
你往分布式存储里写一个文件,这个文件最终落在哪台服务器的哪块磁盘上,是谁决定的?
不是管理员手动指定,也不是随机扔,而是一个叫CRUSH的算法算出来的。这篇文章把CRUSH从输入到输出的完整流程拆开讲清楚,包括它为什么不用传统哈希、怎么通过Rule控制副本分布、以及实际部署中容易踩的坑。
一、CRUSH是什么
CRUSH,全称 Controlled Replication Under Scalable Hashing(可控副本的可扩展哈希),是Ceph分布式存储系统的核心数据分布算法。它的职责很明确:给定一个数据对象,计算出它应该存放在哪些OSD(Object Storage Device,对象存储设备)上。
"可控"是关键词。传统哈希算法是"撒"数据,撒到哪算哪,你管不了。CRUSH的"Controlled"体现在:你可以通过Rule(规则)精确控制副本放在哪个机架、哪个节点、哪块盘上,而不是交给随机数。
深信服EDS的EDSFS存储引擎基于改进的CRUSH算法实现数据分布,在原版CRUSH基础上增加了权重感知和负载均衡能力,后面会展开讲。
二、为什么不用传统一致性哈希
分布式存储领域,数据分布算法不止CRUSH一个。最常被拿来对比的是一致性哈希(Consistent Hashing)。很多人会问:既然一致性哈希已经解决了"节点增减时尽量少搬数据"的问题,为什么还要搞一个CRUSH?
三个核心原因:
1. 一致性哈希的迁移量仍然不够小
一致性哈希在节点增减时,只有相邻环段的数据需要迁移,看起来已经很优了。但在大规模集群中,每次扩容仍然会有相当比例的数据发生迁移。CRUSH的做法不同——它基于集群拓扑的层级结构计算,扩容时只有涉及新节点的PG需要重新映射,已有数据不需要全量重分布。迁移粒度从"对象级"变成了"PG级",数据搬迁量大幅减少。
2. 一致性哈希无法控制副本落在不同故障域
这是最致命的问题。一致性哈希只管"把数据均匀分布",不管"副本之间是否隔离"。假设你有3个副本,一致性哈希可能把其中2个副本落在同一个机架上。一旦这个机架断电,2个副本同时丢失,数据就没了。
CRUSH通过Rule可以显式指定:副本1选host A,副本2必须选host B,副本3必须选host C——三个副本强制分布在不同host上。这种故障域隔离能力,是一致性哈希做不到的。
3. CRUSH的Rule机制让放置策略可定义
一致性哈希的分布策略是固定的——哈希函数决定一切,你想改策略只能换哈希函数。CRUSH的Rule是一段可配置的逻辑,你可以定义:
- 副本数是几个
- 每个副本要在哪个层级做隔离(host级、rack级、row级)
- 是否要走纠删码模式
- 是否要区分SSD和HDD的存储池
改Rule不用改算法,改配置就行。这种灵活性是工程上非常需要的。
三、CRUSH怎么工作:从对象到OSD的完整链路
CRUSH不是一步到位的。一个数据对象从写入到最终落到磁盘上,经过两次映射。下面按顺序拆解。
第一步:对象 → PG(Placement Group)
数据对象先经过一次哈希映射,落到一个PG(Placement Group,归置组)里。计算公式:
```
pg_id = hash(对象名) % PG数量
```
PG是什么?你可以把它理解为一个"数据桶"。一个存储集群有几千到几万个PG,每个PG负责一批对象。引入PG这层中间映射,是为了减少CRUSH的计算频率——对象直接映射到OSD的话,每次集群拓扑变化都要对所有对象重新计算,对象数量动辄上亿,计算量爆炸。有了PG,只需要对PG数量级别的数据做CRUSH计算,对象到PG的映射不变。
举个例子:集群有1024个PG,你写一个叫"report.pdf"的文件,系统先算 `hash("report.pdf") % 1024`,假设结果是768,这个文件就归PG 768管。
第二步:PG → OSD(CRUSH核心计算)
PG拿到ID后,交给CRUSH算法计算它应该落在哪些OSD上。CRUSH的输入有三个:
| 输入 | 说明 |
|---|---|
| PG ID | 上一步算出来的归置组编号 |
| Rule | 放置规则,定义副本数和故障域隔离策略 |
| Cluster Map | 集群拓扑图,描述所有OSD的层级关系 |
输出是一组OSD列表,比如 `[OSD.12, OSD.35, OSD.78]`,表示这个PG的主副本在OSD.12,另外两个副本在OSD.35和OSD.78。
第三步:Cluster Map——集群拓扑的树状结构
CRUSH能做故障域隔离,靠的是Cluster Map。这是一棵树,层级从上到下:
```
root(根)
└── row(行/区域)
└── rack(机架)
└── host(主机/节点)
└── osd(存储设备)
└── disk(磁盘)
```
每个OSD是叶子节点,挂在某个host下面;每个host挂在某个rack下面,以此类推。CRUSH在选择OSD时,会沿着这棵树从上往下走,每经过一个层级就做一次选择和隔离判断。
第四步:Rule——怎么选OSD的
Rule是一段步骤化的逻辑,定义了CRUSH遍历Cluster Map的方式。以一个典型的3副本Rule为例:
```
rule replicated_rule {
ruleset 0
type replicated
min_size 1
max_size 10
step take root # 从root开始
step chooseleaf firstn 0 type host # 选3个不同host下的OSD
step emit # 输出结果
}
```
这段Rule的意思是:
1. take root:从Cluster Map的root节点开始
2. chooseleaf firstn 0 type host:选择3个(firstn 0表示选num_replicas个)不同的host,然后从每个被选中的host下面再选一个OSD
3. emit:输出最终的OSD列表
关键在 `type host` 这个参数——它指定了故障域隔离级别。设成host,意味着3个副本必须落在3个不同的host上。如果设成 `type rack`,则3个副本必须落在3个不同的机架上,隔离级别更高,能容忍整个机架故障。
故障域隔离的实际效果
假设集群有3个机架,每个机架4台主机,每台主机6块OSD:
- Rule设 `type host`:3副本分布在3个不同host上,单host宕机不丢数据,但同一机架断电可能导致部分PG的2个副本同时不可用(如果这2个副本恰好在这个机架的不同host上)
- Rule设 `type rack`:3副本分布在3个不同机架上,单机架整体故障不丢数据,隔离级别最高
选择哪个级别取决于你的故障场景预期。一般中小型集群用host级隔离就够了,大型集群或对可用性要求极高的场景建议rack级。
四、CRUSH在实际运维中的影响
理解了CRUSH的原理,再看运维中的几个典型场景就清晰了。
场景1:集群扩容
新增3台节点接入集群后,Cluster Map更新。CRUSH重新计算所有PG的OSD映射。由于新节点在Cluster Map中新增了权重,部分PG会被重新映射到新节点上的OSD。但关键在于:只有被重新映射的PG需要迁移数据,其余PG的OSD列表不变,已有数据原地不动。
这和一致性哈希的区别在于:一致性哈希扩容时,新节点相邻环段的所有对象都要迁移;CRUSH扩容时,迁移以PG为单位,粒度更粗但总量更可控。实际工程中,往一个已有100TB数据的集群加3台节点,数据迁移量通常在几个TB级别,而不是全量重分布。
场景2:节点故障
某台host宕机,Cluster Map中该host下的OSD被标记为down。CRUSH重新计算涉及这些OSD的PG,将它们重新映射到其他存活的OSD上。这个过程是自动的——存储集群检测到OSD离线后,触发PG的rebackfill(回填),从剩余副本复制数据到新选出的OSD,恢复副本数。
场景3:深信服EDS的改进
原版Ceph的CRUSH算法存在一个已知问题:权重计算不够精细,容易导致数据分布不均衡,尤其在节点异构(不同容量磁盘混布)的场景下。深信服EDS的EDSFS引擎在CRUSH基础上做了改进:
- 权重感知:不只是按OSD数量分配,而是按实际容量权重动态调整,大容量盘多分数据,小容量盘少分数据
- 负载均衡:在CRUSH计算结果基础上做二次均衡,避免某些OSD成为热点
- 纠删码支持:CRUSH算法不只支持副本模式,也支持纠删码模式,两者的选择我们之前详细对比过(EDS副本数和纠删码选哪个),副本模式适合小文件和高随机读写场景,纠删码适合大文件和容量优先的归档场景
五、实际部署中要注意什么
CRUSH算法本身设计精巧,但用不好会出大问题。以下三个是工程中最常见的坑。
1. PG数量设置不当导致数据不均衡
PG数量在创建存储池时设定,后续修改成本高(要触发PG分裂和数据重分布)。PG太少,每个PG承载的数据量大,单PG迁移耗时长;PG太多,CRUSH计算开销和内存占用上升。
官方建议:每个OSD承载50-100个PG。计算公式:
```
总PG数 = OSD数量 × 每OSD期望PG数 / 副本数
```
例如:30个OSD,3副本,每OSD目标100个PG:
```
总PG数 = 30 × 100 / 3 = 1000
```
取最近的2的幂次,设为1024。如果设成128,每OSD只有约13个PG,数据分布容易出现倾斜;如果设成8192,每OSD约273个PG,CRUSH计算和内存开销明显增大。
2. CRUSH Rule写错导致副本落在同一故障域
这是最危险的错误。如果Rule里 `type` 设成了 `osd` 而不是 `host`,CRUSH只保证3个副本落在3个不同的OSD上,但不保证它们在不同的host上。结果可能是:3个副本全在同一个host的3块盘上,这台host一宕机,数据全丢。
排查方法:用 `crushtool --test --show-mappings` 检查PG到OSD的实际映射,确认同一PG的多个副本确实分布在不同故障域。生产环境上线前务必验证。
3. 大规模集群的CRUSH计算开销
集群规模到100+节点、数千个OSD时,CRUSH每次计算都要遍历Cluster Map的层级树,计算量不可忽视。虽然单次计算是毫秒级,但全集群PG重新映射时(比如大面积OSD故障恢复),数千个PG同时触发CRUSH重算,CPU会出现明显峰值。
应对方式:
- 控制单次拓扑变更的规模,分批次接入新节点
- 合理设置PG数量,避免PG过多导致计算放大
- 关注CRUSH Tree的层级深度,层级过深会增加遍历开销
写在最后
CRUSH算法的核心价值在于:把数据分布从一个纯哈希问题,变成了一个可配置的拓扑感知问题。它让分布式存储在扩容、故障恢复、副本隔离这三个关键场景上都有了确定性的控制能力。
理解CRUSH的原理,对于做分布式存储的选型和运维都有实际意义。如果你在评估超融合和分布式存储的区别,或者想知道超融合方案怎么选,CRUSH的数据分布机制是一个重要的技术判断维度——超融合通常把计算和存储融合部署,分布式存储则专注存储层独立扩展,两者在CRUSH的利用方式和故障域设计上有明显差异。
实际部署中,PG数量规划、Rule配置验证、大规模集群的计算开销管理,是把CRUSH用好的三个关键点。配置正确,CRUSH是分布式存储数据可靠性的基石;配置错误,它也可能成为数据丢失的隐患。

 客服 13510444731 15815529276
 二对一售前售后服务
 7x24小时技术保障


 立即咨询
 电话咨询